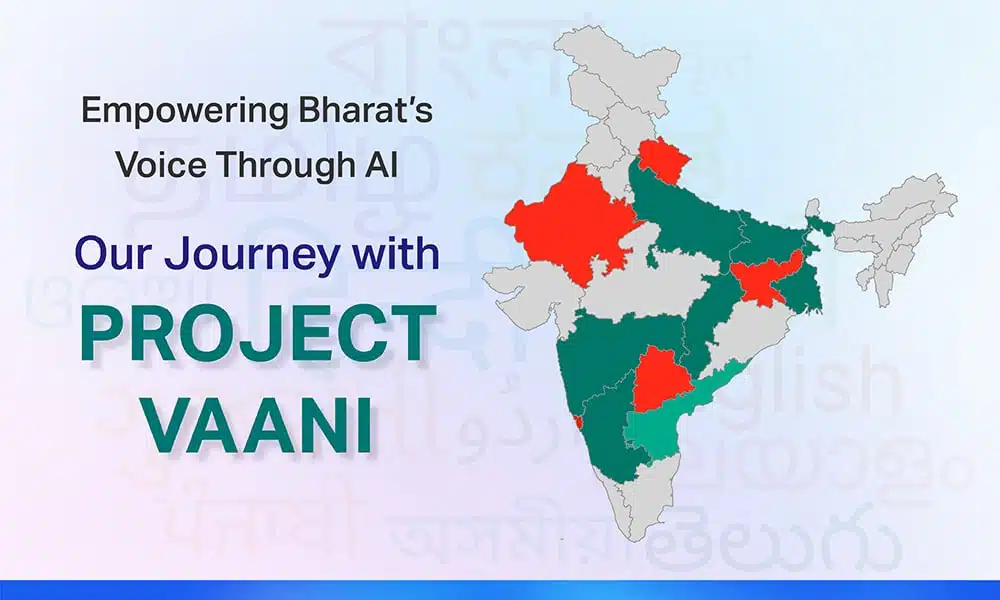
ในประเทศที่มีความหลากหลายทางวัฒนธรรมและภาษาอย่างอินเดีย การสร้าง AI ที่ครอบคลุมเริ่มต้นด้วยการรวบรวมชุดข้อมูลที่มีคุณภาพสูงและเป็นตัวแทน นั่นคือวิสัยทัศน์เบื้องหลังโครงการ Vaaniซึ่งเป็นโครงการขนาดใหญ่แบบโอเพนซอร์สที่นำโดยARTPARK , IISc BengaluruและGoogleโดยมีเป้าหมายเพื่อให้ทุกภาษาและสำเนียงของอินเดียได้มีเสียงพูด
เป้าหมายที่ท้าทายคือ การรวบรวมข้อมูลเสียงพูดมากกว่า 150,000 ชั่วโมงและข้อมูลถอดเสียงมากกว่า 15,000 ชั่วโมงจากผู้คน 1 ล้านคนใน773 เขตของประเทศอินเดีย
ในฐานะหนึ่งในผู้จำหน่ายหลักสำหรับภารกิจระดับชาติครั้งนี้Shaipมีบทบาทสำคัญในการจัดการข้อมูลคำพูดที่เกิดขึ้นเองตามธรรมชาติ การถอดเสียง และการรวบรวมข้อมูลเมตา ซึ่งเป็นการวางรากฐานสำหรับเทคโนโลยีเสียงที่เป็นธรรมซึ่งสะท้อนถึงความเป็นจริงของอินเดียอย่างแท้จริง
วิสัยทัศน์เบื้องหลังโครงการ Vaani
โครงการ Vaani ถูกออกแบบมาเพื่อลดช่องว่างการเข้าถึง AI โดยการสร้างชุดข้อมูลแบบหลายรูปแบบ หลายภาษา และโอเพนซอร์สที่ใหญ่ที่สุดในอินเดีย ข้อมูลนี้เป็นพื้นฐานสำคัญสำหรับการพัฒนาระบบการรู้จำเสียง การแปล และ AI สร้างสรรค์ที่แม่นยำในภาษาพื้นเมืองของอินเดีย ซึ่งหลายภาษายังไม่ได้รับการนำเสนออย่างเพียงพอในระบบนิเวศเทคโนโลยีระดับโลก
วิสัยทัศน์ในระยะยาวคือการขับเคลื่อนแอปพลิเคชันที่สร้างผลกระทบใน:
- การดูแลสุขภาพ – การแพทย์ทางไกลผ่านเสียง
- การศึกษา – แพลตฟอร์มการเรียนรู้ภาษาพื้นเมือง
- การกำกับดูแลกิจการ – อินเทอร์เฟซการสนทนาสำหรับบริการประชาชน
- การเข้าถึง – เครื่องมือเสียงสำหรับผู้ใช้ที่มีความสามารถแตกต่างกัน
- การตอบสนองภัยพิบัติ – การสื่อสารแบบเรียลไทม์ในภาษาถิ่น
Shaip ช่วยสร้างชุดข้อมูลเสียงโอเพนซอร์สที่ใหญ่ที่สุดในอินเดียสำหรับ Project Vaani ได้อย่างไร
Shaip ได้รับมอบหมายให้รวบรวมข้อมูลคำพูดที่เกิดขึ้นเองตามธรรมชาติจำนวน 8,000 ชั่วโมงและถอดเสียงที่ผ่านการตรวจสอบด้วยตนเองอีก 800 ชั่วโมงหน้าที่ของเราครอบคลุมตั้งแต่การเตรียมความพร้อมผู้พูด การบันทึกเสียง การติดแท็กข้อมูลเมตา การประสานงานการถอดเสียง และการควบคุมคุณภาพ
ข้อมูลเสียงแบบธรรมชาติ8,000 ชั่วโมง
บันทึกเสียงจากผู้พูดภาษาแม่กว่า 400 คนต่อเขตซึ่งเป็นตัวแทนของกลุ่มอายุ เพศ และสำเนียงที่หลากหลาย
ครอบคลุม80 เขต
การใช้ภาพประกอบเพื่อช่วยให้การพูดเป็นธรรมชาติและสอดคล้องกับบริบท
นี่คือสิ่งที่ทำให้แนวทางของเราไม่เหมือนใคร:
ความหลากหลายในระดับอำเภอ
เรารวบรวมเสียงจาก 80 เขตที่กระจายอยู่ในรัฐต่างๆ เช่น พิหาร อุตตรประเทศ กรณาฏกะ เบงกอลตะวันตก และมหาราษฏระ โดยแต่ละเขตได้ส่งข้อมูลเสียง 100 ชั่วโมงเพื่อให้เกิดความสมดุลในแต่ละภูมิภาค นอกจากนี้ เรายังดึงเจ้าของภาษาเข้ามามีส่วนร่วม เพื่อให้เกิดการนำเสนอสำเนียงและภาษาถิ่นของภูมิภาคที่มักถูกมองข้ามในชุดข้อมูล AI กระแสหลัก
การเป็นตัวแทนด้านภาษาและประชากรศาสตร์
เรารวบรวมเสียงจาก 80 เขตที่กระจายอยู่ในรัฐต่างๆ เช่น พิหาร อุตตรประเทศ กรณาฏกะ เบงกอลตะวันตก และมหาราษฏระ โดยแต่ละเขตได้ส่งข้อมูลเสียง 100 ชั่วโมงเพื่อให้เกิดความสมดุลในแต่ละภูมิภาค นอกจากนี้ เรายังดึงเจ้าของภาษาเข้ามามีส่วนร่วม เพื่อให้เกิดการนำเสนอสำเนียงและภาษาถิ่นของภูมิภาคที่มักถูกมองข้ามในชุดข้อมูล AI กระแสหลัก
คำพูดที่กระตุ้นด้วยภาพ
เพื่อกระตุ้นคำศัพท์ตามธรรมชาติ ผู้เข้าร่วมจะได้ดูภาพ 45–90 ภาพต่อเซสชัน และขอให้บรรยายภาพเหล่านั้น ผู้เข้าร่วมจะได้รับคำแนะนำโดยใช้ภาพที่หลากหลาย ตั้งแต่สัญลักษณ์ทางวัฒนธรรมไปจนถึงสิ่งของในชีวิตประจำวัน เพื่อกระตุ้นให้เกิดการตอบสนองตามธรรมชาติในภาษาแม่ของตน วิธีนี้ช่วยให้มั่นใจได้ว่าการบันทึกจะสะท้อนคำพูดตามบริบทในโลกแห่งความเป็นจริง ซึ่งถือเป็นสิ่งสำคัญสำหรับการฝึกระบบ NLP ขั้นสูง
มาตรฐานการถอดเสียงคุณภาพสูง
มีการถอดเสียงข้อมูลคำพูดเพียง 10% เท่านั้น ซึ่งรวมเป็นเวลา 800 ชั่วโมง การถอดเสียงดำเนินการโดยนักภาษาศาสตร์ในพื้นที่ซึ่งอยู่ภายในรัศมี 20–50 กม. จากผู้พูด เพื่อให้แน่ใจว่าคุ้นเคยกับภาษาถิ่นและความแตกต่างต่างๆ การตรวจสอบชั้นที่สองทำให้มั่นใจได้ว่ามีอัตราข้อผิดพลาดของคำ (WER) น้อยกว่า 5%
การประกันคุณภาพที่เข้มงวด
ข้อมูลเสียงต้องผ่านเกณฑ์มาตรฐานสูง ได้แก่ ไม่มีเสียงรบกวนพื้นหลัง เสียงสะท้อน เสียงสั่นของโทรศัพท์ หรือเสียงผิดเพี้ยน เสียงจะถูกบันทึกในสภาพแวดล้อมที่เงียบและไม่มีเสียงสะท้อน ไฟล์จะต้องผ่านการตรวจสอบอย่างเข้มงวดเพื่อให้เป็นไปตามหลักเกณฑ์ด้านความชัดเจนของเสียงพูด ระดับเสียง ความถูกต้องของข้อมูลเมตา และการตรวจสอบผู้พูด การแท็กข้อมูลเมตาจะต้องแม่นยำสำหรับไฟล์ทั้งหมด และต้องตรวจสอบการบันทึกเสียงทั้งหมดเพื่อดูว่าผู้พูดและตำแหน่งตรงกันหรือไม่

ความท้าทายที่เราแก้ไขได้
- โลจิสติกส์ระยะไกล – บริหารจัดการทีมงานครอบคลุม 80 เขต
- ความหลากหลายของผู้พูด – ต้อนรับผู้พูดที่ผ่านการตรวจสอบแล้วมากกว่า 32,000 คนในสถานที่ห่างไกล
- ความอ่อนไหวทางวัฒนธรรม – การเคารพขนบธรรมเนียมและภาษาถิ่น
- ความสมบูรณ์ของข้อมูล – ตอบสนองมาตรฐานคุณภาพและการปฏิบัติตาม
- การควบคุมคุณภาพ – ข้ามบริบททางภาษาและวัฒนธรรมที่หลากหลาย
ความสำเร็จของเราเกิดจากการวางแผนที่พิถีพิถัน การตรวจสอบที่ขับเคลื่อนด้วยเทคโนโลยี และความร่วมมือกับทีมงานในท้องถิ่นที่เข้าใจความแตกต่างทางวัฒนธรรมของแต่ละภูมิภาค
ผลกระทบและการประยุกต์
การสนับสนุนของ Shaip ไม่เพียงแต่เร่งความก้าวหน้าของ Project Vaani เท่านั้น แต่ยังวางรากฐานสำหรับ AI แบบครอบคลุมในอินเดียอีกด้วย ชุดข้อมูลเสียงที่คัดสรรมาอย่างดีกำลังถูกใช้เพื่อสร้างและปรับแต่งโมเดล AI สำหรับ:
- ผู้ช่วยเสียงภาษาพื้นเมือง
- เครื่องมือแปลระดับภูมิภาค
- เครื่องมือสื่อสารที่เข้าถึงได้สำหรับผู้พิการทางสายตา
- แพลตฟอร์ม Edtech ที่ขับเคลื่อนด้วย AI สำหรับนักเรียนในชนบท
- การแพทย์ทางไกลในชนบท
- บริการประชาชนผ่านเสียง
- การแปลและการถอดเสียงแบบเรียลไทม์
สรุป
โครงการ Vaani เป็นก้าวสำคัญสู่ปัญญาประดิษฐ์ (AI) ที่ครอบคลุมและเข้าถึงได้ และ Shaip รู้สึกเป็นเกียรติที่ได้มีบทบาทสำคัญในฐานะผู้ริเริ่มโครงการนี้ งานของ Shaip ในโครงการ Vaani ตอกย้ำความมุ่งมั่นของเราในการสร้างระบบ AI ที่มีจริยธรรม ครอบคลุม และมีรากฐานมาจากความหลากหลายและการเป็นตัวแทนด้วยการเก็บรวบรวมเสียงพูดกว่า 8,000 ชั่วโมง และการถอดเสียงกว่า 800 ชั่วโมง เราภูมิใจที่ได้มีส่วนร่วมในหนึ่งในโครงการด้านการเข้าถึงดิจิทัลที่ล้ำสมัยที่สุดของอินเดีย
ขณะที่ Project Vaani ยังคงมุ่งหน้าสู่เป้าหมายที่ยิ่งใหญ่กว่าในการเก็บข้อมูลให้ได้ 150,000 ชั่วโมง เรายินดีที่จะสนับสนุนขอบเขตใหม่ของนวัตกรรม AI ที่เข้าถึงและเพื่อชาวอินเดียทุกคน
สนใจร่วมเป็นพันธมิตรกับเราเพื่อสร้าง AI ที่เข้าใจโลกแห่งความเป็นจริงหรือไม่? www.shaip.com