โดยการใช้ประโยชน์จาก NLP ที่ขับเคลื่อนด้วย AI เพื่อดึงข้อมูลที่มีโครงสร้างจาก EHR ที่ไม่มีโครงสร้างจำนวนมาก นักวิจัยสามารถเข้าถึงชุดข้อมูลทางคลินิกขนาดใหญ่สำหรับการศึกษาทางระบาดวิทยา สุขภาพประชากร และการค้นพบข้อมูลเชิงลึกทางการแพทย์ที่ปกติแล้วจะไม่เปิดเผย
การดึงรายละเอียดจากข้อมูล EHR ที่ไม่มีโครงสร้าง 101: ตัวอย่างเวิร์กโฟลว์
กระบวนการดึงข้อมูลเชิงลึกจากข้อมูล EHR ที่ไม่มีโครงสร้างนั้นเป็นระบบและต้องดำเนินการเป็นรายกรณี ข้อกำหนดเฉพาะด้าน ข้อกังวลและความท้าทายขององค์กรด้านการดูแลสุขภาพ การประยุกต์ใช้งานที่มุ่งเน้นวัตถุประสงค์ และผลกระทบโดยรอบล้วนแล้วแต่เป็นความคิดเห็นส่วนบุคคล ดังนั้น กระบวนการนี้จึงควรพิจารณาปัจจัยต่างๆ ที่มีอิทธิพลต่อองค์กรและวิสัยทัศน์ขององค์กรด้วย
อย่างไรก็ตาม เช่นเดียวกับแนวทางแต่ละแนวทางที่มีเวิร์กโฟลว์ที่เฉพาะเจาะจงหรือแนวทางที่เป็นหลักเกณฑ์ทั่วไป เราก็ได้ระบุเอกสารเบื้องต้นไว้ให้คุณอ้างอิงด้วยเช่นกัน
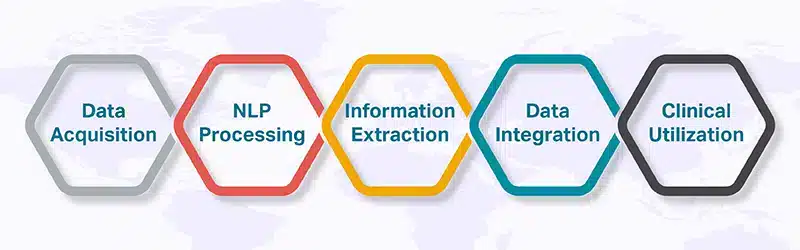
การรวบรวมและประมวลผลข้อมูลเบื้องต้น:ขั้นตอนแรกคือการรวบรวมข้อมูล EHR ซึ่งประกอบด้วยบันทึกทางการแพทย์ รายการยา รายการแพ้ยา และรายงานขั้นตอนการรักษา การประมวลผลเบื้องต้นในโหมด AI ประกอบด้วยการปกปิดข้อมูลส่วนบุคคล การทำความสะอาด การทำให้เป็นมาตรฐาน และการแยกคำเพื่อเตรียมข้อมูลให้อยู่ในรูปแบบที่สอดคล้องกัน (รูปแบบข้อความ โครงสร้างเทียบกับไม่มีโครงสร้าง)
การประมวลผล NLP / การฝึกโมเดล AI:ข้อมูลที่รวบรวมได้จะถูกป้อนเข้าสู่ขั้นตอนวิธี NLP หรือโมเดล AI เพื่อวิเคราะห์ข้อมูลข้อความ ระบุเอนทิตีทางคลินิกที่สำคัญ เช่น การวินิจฉัยโรค ยา อาการแพ้ และขั้นตอนการรักษา การฝึกใน "โหมด AI" เกี่ยวข้องกับการเรียนรู้แบบมีผู้กำกับดูแล บางครั้งอาจเป็นการเรียนรู้แบบไม่มีผู้กำกับดูแลหรือกึ่งมีผู้กำกับดูแล โดยใช้ชุดข้อมูลที่มีป้ายกำกับ
การสกัดข้อมูล:ขึ้นอยู่กับว่าโมเดลของคุณใช้กลยุทธ์การเรียนรู้แบบมีผู้กำกับดูแลหรือแบบไม่มีผู้กำกับดูแล (หรือโหมด AI แบบผสมผสาน) มันจะสกัดข้อมูลที่เกี่ยวข้องเกี่ยวกับแต่ละเอนทิตี รวมถึงประเภท วันที่ รายละเอียดที่เกี่ยวข้อง ความรุนแรง ปริมาณยา ฯลฯ
การตรวจสอบความถูกต้องและการกำกับดูแลทางคลินิก:เมื่อแบบจำลองที่ขับเคลื่อนด้วย AI ดึงข้อมูลออกมาแล้ว ข้อมูลนั้นจะต้องได้รับการตรวจสอบความถูกต้องทางคลินิกโดยผู้เชี่ยวชาญด้านการดูแลสุขภาพ ระบบที่มีมนุษย์เข้ามาเกี่ยวข้องและวงจรการรับฟังความคิดเห็นจากผู้เชี่ยวชาญช่วยให้มั่นใจได้ว่าการดึงข้อมูลนั้นเชื่อถือได้
การบูรณาการข้อมูลและการทำงานร่วมกัน:จากนั้นข้อมูลที่มีโครงสร้างจะถูกบูรณาการเข้ากับระบบ EHR หรือฐานข้อมูลอื่น ๆ ที่เกี่ยวข้อง เพื่อให้มั่นใจว่าสอดคล้องกับมาตรฐาน HL7 FHIR มาตรฐานด้านการดูแลสุขภาพอื่น ๆ และสนับสนุนการทำงานร่วมกัน
วงจรการนำไปใช้ทางคลินิกและการให้ข้อเสนอแนะ:การบูรณาการนี้ช่วยให้ผู้เชี่ยวชาญด้านการดูแลสุขภาพสามารถใช้ข้อมูลที่ดึงออกมาเพื่อการตัดสินใจทางคลินิก การวิจัย และโครงการด้านสาธารณสุข วงจรการให้ข้อเสนอแนะในโหมด AI ช่วยปรับปรุงความแม่นยำของแบบจำลองเมื่อเวลาผ่านไป โดยปรับให้เข้ากับข้อมูลประเภทใหม่หรือรูปแบบทางภาษา
ความท้าทายในการใช้ประโยชน์จาก NLP เพื่อดึงข้อมูล EHR
ภารกิจในการดึงข้อมูลที่ไม่มีโครงสร้างจาก EHR นั้นมีความท้าทายและสามารถทำให้ชีวิตของผู้มีส่วนได้ส่วนเสียด้านการดูแลสุขภาพง่ายขึ้น อย่างไรก็ตาม ยังมีปัญหาคอขวดที่อาจเป็นอุปสรรคต่อกระบวนการนำไปใช้งานที่ราบรื่น ลองมาดูข้อกังวลที่พบบ่อยที่สุด เพื่อให้คุณสามารถวางแผนเชิงรุกเพื่อจัดการหรือบรรเทาปัญหาเหล่านั้นได้
คุณภาพ ความหลากหลาย และอคติของข้อมูล:ความแม่นยำของการสกัดข้อมูลด้วย NLP ขึ้นอยู่กับคุณภาพ ความสม่ำเสมอ และความเป็นตัวแทนของข้อมูล EHR รูปแบบ คำศัพท์ที่แตกต่างกัน บันทึกที่ไม่สมบูรณ์ หรือตัวอย่างที่มีอคติ สามารถลดประสิทธิภาพของโมเดล AI ได้
ความเป็นส่วนตัว ความปลอดภัย และการปฏิบัติตามกฎระเบียบในโหมด AI:จำเป็นต้องมีการดำเนินการเพื่อรับรองความเป็นส่วนตัวของผู้ป่วยและความปลอดภัยของข้อมูลในระหว่างการประมวลผลและการจัดเก็บข้อมูลด้วย NLP/AI ต้องปฏิบัติตามแนวทางกฎระเบียบ เช่น GDPR, HIPAA เป็นต้น ซึ่งรวมถึงการลบข้อมูลระบุตัวตน การจัดเก็บข้อมูลอย่างปลอดภัย และการควบคุมการเข้าถึง
การตรวจสอบความถูกต้องทางคลินิกและการตีความได้:ข้อมูลที่ดึงออกมาต้องได้รับการตรวจสอบความถูกต้องโดยผู้เชี่ยวชาญด้านการดูแลสุขภาพเพื่อให้มั่นใจในความถูกต้องและความเกี่ยวข้องทางคลินิก คำศัพท์ที่ซับซ้อน ถ้อยคำที่คลุมเครือ หรือภาวะที่หายากอาจทำให้แบบจำลองสับสน นอกจากนี้ ระบบในโหมด AI ต้องสามารถอธิบายได้เพื่อให้แพทย์ไว้วางใจ
การบูรณาการ การทำงานร่วมกัน และมาตรฐาน:ข้อมูลที่ดึงออกมาจะต้องได้รับการบูรณาการอย่างราบรื่นกับระบบ EHR ที่มีอยู่และระบบไอทีด้านการดูแลสุขภาพอื่นๆ โมเดล AI ควรสนับสนุน HL7, FHIR, SNOMED, RadLex เป็นต้น เพื่อให้มั่นใจถึงการทำงานร่วมกันได้
ความสามารถในการขยายขนาดและการบำรุงรักษา:ในโหมด AI ระบบจำเป็นต้องได้รับการฝึกอบรมใหม่ การตรวจสอบ และการกำหนดเวอร์ชันอย่างต่อเนื่อง เพื่อรองรับแนวทางการปฏิบัติทางคลินิกใหม่ ๆ คำศัพท์ทางการแพทย์ที่เปลี่ยนแปลงไป หรือการเปลี่ยนแปลงในรูปแบบเอกสาร
ต้นทุนและความต้องการทรัพยากร:การพัฒนา การฝึกอบรม การตรวจสอบความถูกต้อง และการใช้งานระบบ NLP ที่ขับเคลื่อนด้วย AI ต้องใช้การลงทุนในการติดป้ายกำกับข้อมูล การกำกับดูแลโดยผู้เชี่ยวชาญ ทรัพยากรด้านการคำนวณ และบุคลากรที่มีคุณสมบัติเหมาะสม
ข้อสรุป
กล่าวโดยสรุป ศักยภาพนั้นไร้ขีดจำกัดเมื่อคุณนำเทคโนโลยี NLP ที่ขับเคลื่อนด้วย AIมาใช้ในการดึงข้อมูลด้านการดูแลสุขภาพจาก EHRs สำหรับการใช้งานที่ได้ผลอย่างสมบูรณ์ เราขอแนะนำให้จัดการกับความท้าทาย บังคับใช้การกำกับดูแลทางคลินิก และรับประกันการใช้งานอย่างมีความรับผิดชอบใน “โหมด AI”
หากคุณต้องการปูทางสู่การปฏิบัติตามข้อกำหนดด้านข้อมูลทางการแพทย์อย่างรัดกุม และต้องการข้อมูลการฝึกอบรม AI ที่ดีที่สุด สำหรับโมเดลของคุณ คุณสามารถติดต่อเราได้ ในฐานะผู้บุกเบิกในอุตสาหกรรม เราเข้าใจในด้านนี้ วิสัยทัศน์ขององค์กรของคุณ และความซับซ้อนที่เกี่ยวข้องกับการฝึกอบรมโมเดล NLP ทางคลินิกที่เหมาะสมกับ AI และใช้งานในวงการแพทย์โดยเฉพาะ ติดต่อเราได้เลยวันนี้