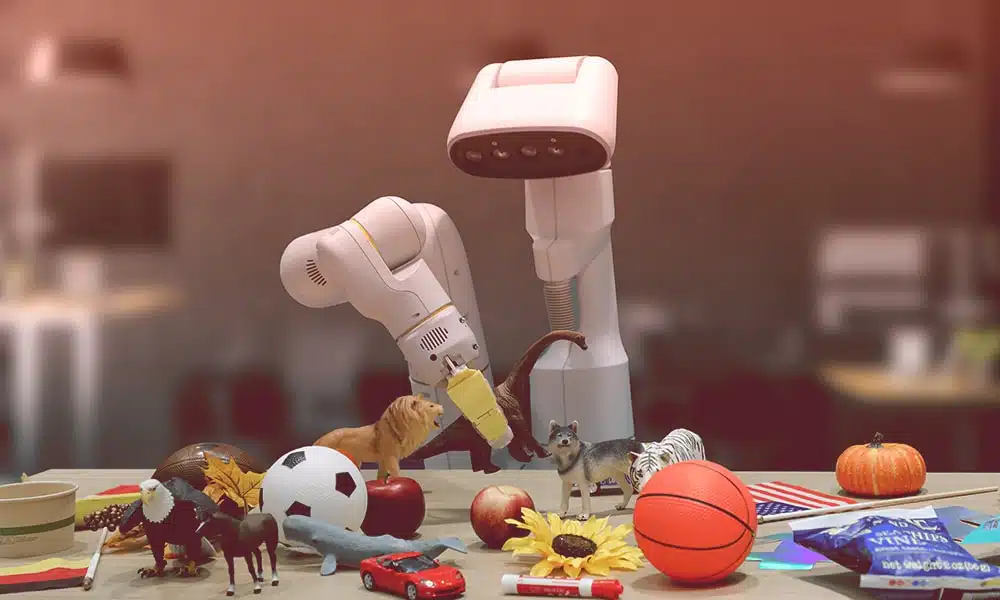
การเปลี่ยนผ่านจากแชทบอทไปสู่หุ่นยนต์ที่ทำตามคำสั่งภาษาธรรมชาติเกิดขึ้นผ่านโมเดลประเภทเดียว โมเดล VLA (Vision-Language-Action Model) คือโมเดลที่รวมการรับรู้ทางสายตา ความเข้าใจภาษา และการสร้างการกระทำเข้าไว้ในเครือข่ายประสาทเทียมเดียว พลังของโมเดลเหล่านี้มีอยู่จริง แต่ขึ้นอยู่กับข้อมูลการฝึกฝนที่ได้รับเกือบทั้งหมด คู่มือนี้จะอธิบายว่าข้อมูลการฝึกฝน VLA ประกอบด้วยอะไรบ้าง ทีมต่างๆ มักประเมินอะไรต่ำไป และวิธีการวางแผนชุดข้อมูลที่จะสร้างโมเดลที่คุ้มค่าแก่การใช้งาน การสร้างชุดข้อมูลนั้นคือสิ่งที่โปรแกรมข้อมูลการฝึกฝน Physical AI ของ Shaip มอบให้ นั่นคือข้อมูลภาพ ภาษา และการกระทำที่ซิงโครไนซ์กัน ซึ่งได้มาจากหุ่นยนต์ในโลกแห่งความเป็นจริง
ประเด็นที่สำคัญ
- โมเดล VLA แปลงข้อมูลภาพและภาษาให้เข้ากับการกระทำของหุ่นยนต์โดยตรงในเครือข่ายเดียว
- ข้อมูลสำหรับการฝึกอบรมต้องประกอบด้วยการสังเกตภาพที่สอดคล้องกัน คำแนะนำทางภาษา และการกระทำ
- โทเค็นการกระทำแบบแยกส่วนจำเป็นต้องใช้ข้อมูลสาธิตขนาดใหญ่เพื่อให้เรียนรู้ได้อย่างมีประสิทธิภาพ
- วิดีโอของมนุษย์ที่เน้นมุมมองตนเองกำลังถูกนำมาใช้มากขึ้นเรื่อยๆ ในฐานะแหล่งข้อมูลการฝึกอบรมเบื้องต้นสำหรับ VLA ที่มีต้นทุนต่ำ
- การประเมินผลที่ครอบคลุมนั้นมีความสำคัญไม่น้อยไปกว่าข้อมูลการฝึกฝนสำหรับการใช้งานที่เชื่อถือได้
- การปรับแต่ง VLA ให้สมบูรณ์แบบจะประสบความสำเร็จหรือล้มเหลวขึ้นอยู่กับความเข้มงวดของการระบุคำอธิบายประกอบ ไม่ใช่ปริมาณข้อมูลดิบเพียงอย่างเดียว
โมเดล VLA คืออะไร?
โมเดล VLA เป็นโมเดลพื้นฐานของหุ่นยนต์ที่รับภาพและคำสั่งภาษาธรรมชาติเป็นอินพุต และส่งออกการกระทำของหุ่นยนต์ แตกต่างจากกระบวนการแบบดั้งเดิมที่แยกการรับรู้ การวางแผน และการควบคุมออกเป็นโมดูลต่างๆ โมเดลวิชั่น-ภาษา-การกระทำ (VLA) เรียนรู้การจับคู่แบบครบวงจรในเครือข่ายเดียว

โมเดล VLA:เครือข่ายประสาทเทียมที่รับข้อมูลการสังเกตภาพที่ซิงโครไนซ์กันและคำสั่งภาษาธรรมชาติ แล้วสร้างลำดับการกระทำของหุ่นยนต์หรือโทเค็นการกระทำ
การออกแบบที่เป็นเอกภาพนี้ช่วยให้โมเดล VLA สืบทอดความสามารถในการให้เหตุผลจากการฝึกฝนล่วงหน้าด้านภาพและภาษาขนาดใหญ่ และขยายความสามารถเหล่านั้นด้วยการควบคุมการเคลื่อนไหว สำหรับการใช้งานจริง นั่นหมายความว่าในทางทฤษฎีแล้ว โมเดลหนึ่งสามารถทำงานได้หลายอย่าง แต่จะทำได้ก็ต่อเมื่อข้อมูลการฝึกฝนครอบคลุมงานเหล่านั้นด้วยโครงสร้างที่เหมาะสมเท่านั้น
ข้อมูลสำหรับการฝึกอบรม VLA ประกอบด้วยอะไรบ้าง?
ข้อมูลการฝึกอบรม VLAประกอบด้วยส่วนประกอบหลักสี่อย่างต่อตอน ได้แก่ การสังเกตด้วยภาพ คำแนะนำด้วยภาษาธรรมชาติ เส้นทางการกระทำ และป้ายกำกับความสำเร็จหรือความล้มเหลว นอกจากนี้ ทีมงานยังเพิ่มการประทับเวลา สถานะการรับรู้ตำแหน่งของร่างกาย และตัวบ่งชี้การประเมินเข้าไปด้วย

สี่ชั้นที่จำเป็น:
- การสังเกตด้วยสายตา — เฟรมภาพ RGB มักใช้ร่วมกับมุมมองความลึกหรือมุมมองจากกล้องข้อมือ
- คำแนะนำภาษา — คำสั่งภาษาธรรมชาติที่กระชับ เช่น “เทน้ำลงในถ้วย”
- เส้นทางการกระทำ — ลำดับการกระทำแบบแยกส่วนหรือแบบต่อเนื่องที่เชื่อมโยงกับองศาอิสระของหุ่นยนต์
- ป้ายกำกับผลลัพธ์ — การระบุอย่างชัดเจนถึงความสำเร็จ ความล้มเหลว หรือความสำเร็จบางส่วนในแต่ละตอน
แบบจำลอง VLA แบบเปิดที่มีพารามิเตอร์ 7 พันล้านตัวได้รับการฝึกฝนด้วยข้อมูลมากกว่าหนึ่งล้านตอนที่ดึงมาจากหุ่นยนต์ 22 รูปแบบ (Stanford et al., 2024) ซึ่งแสดงให้เห็นถึงความหลากหลายที่คาดหวังได้สำหรับการสรุปผลข้ามงาน หากปราศจากความกว้างขวางนี้ แบบจำลอง VLA มักจะจดจำวัตถุเฉพาะมากกว่าที่จะสรุปผลทั่วไป
เหตุใดการระบุการกระทำจึงยากกว่าการระบุภาพ?
การระบุรายละเอียดการกระทำนั้นยากกว่า เพราะการกระทำเกิดขึ้นในพื้นที่ต่อเนื่องที่มีมิติสูง และขึ้นอยู่กับลักษณะทางกายภาพของหุ่นยนต์ ไม่ใช่แค่เนื้อหาในเฟรม การติดป้ายกำกับกรอบสี่เหลี่ยมรอบถ้วยนั้นทำได้ง่าย แต่การติดป้ายกำกับวิถีการเคลื่อนที่ที่จับถ้วยนั้นได้สำเร็จด้วยตัวจับยึดเฉพาะที่จุดสัมผัสเฉพาะนั้นไม่ใช่เรื่องง่าย
โทเค็นการกระทำ:การแสดงผลแบบแยกส่วนของการเคลื่อนที่ของหุ่นยนต์หรือการกระจัดของปลายแขนกล ซึ่งแบบจำลอง VLA สามารถทำนายได้เช่นเดียวกับโทเค็นในภาษา
ทีมงานที่ทำหน้าที่ระบุคำอธิบายประกอบจำเป็นต้องจัดเรียงโทเค็นการกระทำแต่ละรายการให้ตรงกับการสังเกตที่ซิงโครไนซ์กัน ทำเครื่องหมายช่วงเวลาการติดต่อ บันทึกการกู้คืนความล้มเหลว และติดแท็กขอบเขตอะตอมของคำสั่งภาษา เวิร์กโฟลว์ การระบุคำอธิบายประกอบข้อมูล ของ Shaip สามารถจัดการสิ่งเหล่านี้ได้ในระดับใหญ่ ด้วยอนุกรมวิธานที่มีโครงสร้างซึ่งปรับให้เข้ากับพื้นที่การกระทำของหุ่นยนต์และเกณฑ์การยอมรับต่อภารกิจ
วิดีโอที่เน้นมุมมองของตนเองจะเหมาะสมกับการฝึกอบรม VLA อย่างไร?

งานวิจัยล่าสุดได้แปลงวิดีโอของมนุษย์แบบไม่มีโครงสร้างและมองจากมุมมองของตนเอง ให้เป็นตอนต่างๆ ในรูปแบบ VLA ซึ่งประกอบด้วย 1 ล้านส่วนและ 26 ล้านเฟรม โดยถือว่ามือของมนุษย์เป็นอวัยวะปลายแขนที่คล่องแคล่ว (Wu et al., arXiv, 2025) ข้อมูลแบบข้ามกายประเภทนี้กลายเป็นเรื่องปกติในสูตรการฝึกฝน VLA แล้ว
ข้อจำกัดคือ วิดีโอต้นฉบับไม่ใช่ข้อมูลสำหรับการฝึกฝน จำเป็นต้องมีการแบ่งส่วน การอธิบายภาษา การปรับท่าทางมือ และการตรวจสอบคุณภาพก่อนที่จะเข้าสู่กระบวนการ VLA การประมวลผลข้อมูล AI ทางกายภาพของ Shaip ประกอบด้วยการจับภาพจากมุมมองบุคคลที่หนึ่ง การแปลงภาพจริงเป็นภาพจำลอง และการใส่คำอธิบายประกอบที่สอดคล้องกับ VLA ในการส่งมอบครั้งเดียว
[อ่านเพิ่มเติม: สำรวจบริการรวบรวมข้อมูลวิดีโอแบบเน้นตนเองของเรา ]
คุณจะสร้างชุดประเมินผลที่สามารถตรวจจับโหมดความล้มเหลวของ VLA ได้อย่างไร?
ชุดประเมินผลจะตรวจจับโหมดความล้มเหลวของ VLA ได้ก็ต่อเมื่อออกแบบชุดประเมินผลก่อนการฝึกอบรม ไม่ใช่หลังจากนั้น โครงสร้างสามอย่างที่สำคัญที่สุด ได้แก่ เกณฑ์มาตรฐานความสำเร็จในการใช้งานจริง การทดสอบการสรุปผลนอกการใช้งานจริง และสถานการณ์ความปลอดภัยที่แบ่งระดับความเสี่ยง
ลองนึกภาพโมเดล VLA สำหรับใช้ในครัวเรือนที่ได้รับการฝึกฝนมาอย่างดีเกี่ยวกับงานในครัว ชุดการประเมินที่เหมาะสมควรทดสอบ: งานที่รู้จักในครัวที่รู้จัก (การใช้งานจริง), งานที่รู้จักในสภาพแสงที่ไม่คุ้นเคย (OOD ระดับอ่อน), วัตถุที่ไม่รู้จักพร้อมคำแนะนำที่รู้จัก (การสรุปแนวคิด) และเหตุการณ์ที่เกิดขึ้นไม่บ่อย เช่น การหกโดยไม่ตั้งใจ (ระดับความปลอดภัย) หากขาดส่วนใดส่วนหนึ่งไป ความเสี่ยงในการใช้งานก็จะวัดไม่ได้
แหล่งข้อมูลที่เป็นกลางและมีประโยชน์สำหรับการจัดระเบียบการครอบคลุมระดับความเสี่ยงคือกรอบการบริหารความเสี่ยงด้าน AI ของ NISTซึ่งแยกประเภทผลกระทบในลักษณะที่สอดคล้องกับการออกแบบชุดการประเมินอย่างชัดเจน