การจดจำเสียงเป็นเทคโนโลยีที่ระบุและยืนยันตัวตนของบุคคลโดยอาศัยลักษณะเฉพาะของเสียง ในขณะที่การจดจำคำพูดซึ่งเป็นเทคโนโลยีที่ใกล้เคียงกัน จะแปลงคำพูดเป็นข้อความหรือคำสั่ง เทคโนโลยีทั้งสองนี้ทำงานร่วมกันในทุกสิ่งตั้งแต่ลำโพงอัจฉริยะและระบบควบคุมในรถยนต์ ไปจนถึงระบบรักษาความปลอดภัยทางการธนาคารและเอกสารทางการแพทย์ ตลาดการจดจำเสียงและคำพูดทั่วโลกมีมูลค่า 20.25 พันล้านดอลลาร์ในปี 2023 และคาดว่าจะสูงถึง 53.67 พันล้านดอลลาร์ในปี 2030 โดยมีอัตราการเติบโตเฉลี่ยต่อปี (CAGR) อยู่ที่ 14.6% (Grand View Research, 2024) และการจดจำเสียงเป็นส่วนงานที่มีการเติบโตเร็วที่สุดในตลาดนี้ (Grand View Research, 2024)
คู่มือนี้อธิบายวิธีการทำงานของระบบจดจำเสียง การใช้งาน ข้อดีและข้อจำกัด และการเปลี่ยนแปลงที่จะเกิดขึ้นในสาขานี้ในปี 2026
ประเด็นที่สำคัญ
- ระบบจดจำเสียงจะระบุว่าใครกำลังพูดอยู่ ส่วนระบบจดจำคำพูดจะเข้าใจสิ่งที่พูด
- ระบบจะวิเคราะห์ระดับเสียง ความถี่ สำเนียง และจังหวะการพูด เพื่อสร้างลายนิ้วมือเสียงที่เป็นเอกลักษณ์
- การใช้งานหลัก: ระบบรักษาความปลอดภัยและไบโอเมตริกซ์ อุปกรณ์สั่งงานด้วยเสียง บริการลูกค้า การดูแลสุขภาพ และยานยนต์
- ความแม่นยำขึ้นอยู่กับข้อมูลการฝึกอบรมที่หลากหลายและมีการติดป้ายกำกับอย่างดี ครอบคลุมสำเนียงและภาษาต่างๆ การจัดหาข้อมูลดังกล่าวในปริมาณมากคือจุดที่ข้อมูลพร้อมใช้งานเข้ามามีบทบาท ชุดข้อมูลคำพูด ช่วยประหยัดเวลาในการรวบรวมข้อมูลให้กับทีมงานได้หลายเดือน
- แนวโน้มในปี 2026 ได้แก่ โมเดล AI แปลงเสียงเป็นเสียง การประมวลผลบนอุปกรณ์ และการป้องกันการปลอมแปลงเสียง (Depthefake)
ขนาดตลาด: ในช่วงเวลาไม่ถึง 20 ปี เทคโนโลยีการจดจำเสียงได้เติบโตอย่างก้าวกระโดด แต่ในอนาคตจะเป็นอย่างไร? ในปี 2020 ตลาดเทคโนโลยีการจดจำเสียงทั่วโลกมีมูลค่าประมาณ 10.7 พันล้านดอลลาร์สหรัฐ และคาดว่าจะพุ่งสูงขึ้นเป็น 27.16 พันล้านดอลลาร์สหรัฐภายในปี 2026 โดยมีอัตราการเติบโตเฉลี่ยต่อปี (CAGR) อยู่ที่ 16.8% ตั้งแต่ปี 2021 ถึง 2026
เทคโนโลยีการจดจำเสียงคืออะไร?
สาขานี้มีต้นกำเนิดมาจากระบบในทศวรรษ 1950 ซึ่งสามารถจดจำได้เพียงตัวเลขไม่กี่หลักเท่านั้น แบบจำลองทางสถิติ และต่อมาคือการเรียนรู้เชิงลึก ได้เปลี่ยนการทดลองในยุคแรกเหล่านั้นให้กลายเป็นผู้ช่วยที่คอยรับฟังตลอดเวลา และระบบตรวจสอบตัวตนด้วยเสียงที่ปลอดภัย ซึ่งมีผู้คนหลายพันล้านคนใช้งานอยู่ในปัจจุบัน
การรู้จำเสียง – ข้อดีและข้อเสีย
การจดจำเสียงทำงานอย่างไร
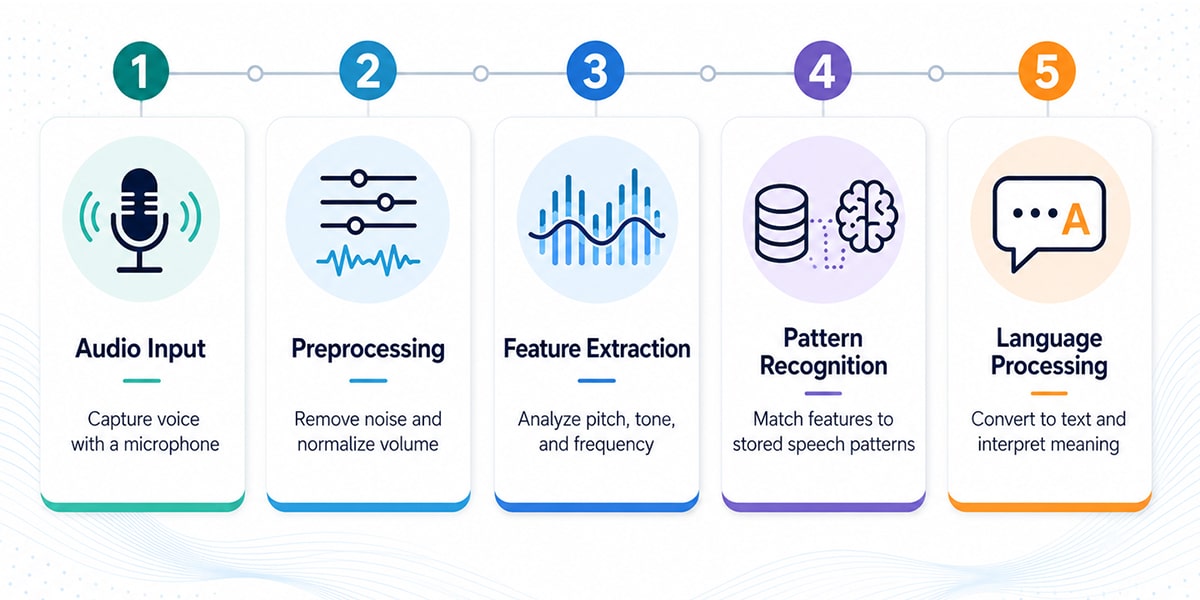
การรับสัญญาณเสียง : กระบวนการเริ่มต้นด้วยการรับสัญญาณเสียงโดยใช้ไมโครโฟน
การประมวลผลเบื้องต้น : สัญญาณเสียงจะได้รับการปรับปรุงให้ดีขึ้นโดยการกำจัดเสียงรบกวนและปรับระดับเสียงให้เป็นมาตรฐาน
การสกัดคุณลักษณะ : ระบบจะวิเคราะห์เสียงเพื่อสกัดคุณลักษณะสำคัญ เช่น ระดับเสียง โทนเสียง และความถี่
การจดจำรูปแบบ : คุณลักษณะที่สกัดได้จะถูกนำไปเปรียบเทียบกับรูปแบบเสียงพูดที่ทราบแล้วซึ่งจัดเก็บไว้ในฐานข้อมูล
การประมวลผลภาษา : รูปแบบที่ตรวจพบจะถูกแปลงเป็นข้อความ และอัลกอริธึมการประมวลผลภาษาธรรมชาติ (NLP) จะตีความหมาย
กรณีการใช้งานการจดจำเสียง
เทคโนโลยีการจดจำเสียงมีการใช้งานที่หลากหลายในสาขาต่างๆ ต่อไปนี้เป็นกรณีการใช้งานที่สำคัญบางส่วน:
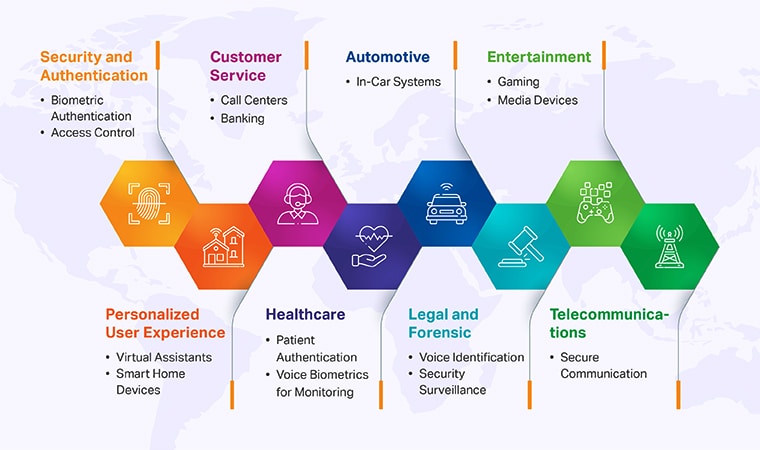
- ความปลอดภัยและการรับรองความถูกต้อง:
- การพิสูจน์ตัวตนแบบไบโอเมตริกซ์: ใช้ในสมาร์ทโฟนและอุปกรณ์อื่นๆ เพื่อปลดล็อคหน้าจอและตรวจสอบตัวตนของผู้ใช้
- Access Control: รักษาความปลอดภัยการเข้าถึงอาคาร พื้นที่ปลอดภัย และข้อมูลที่เป็นความลับโดยจดจำบุคลากรที่ได้รับอนุญาต
- ผลิตภัณฑ์การจดจำเสียงตัวอย่าง ได้แก่ อุปกรณ์บ้านอัจฉริยะและระบบรักษาความปลอดภัยที่ใช้การจดจำเสียงเพื่อการควบคุมแบบแฮนด์ฟรีและรักษาความปลอดภัยเพิ่มมากขึ้น
- ประสบการณ์ผู้ใช้ส่วนบุคคล:
- ผู้ช่วยเสมือน: ปรับแต่งการตอบสนองและการกระทำตามเสียงของผู้ใช้ ทำให้เกิดการโต้ตอบที่เป็นส่วนตัวมากขึ้น
- อุปกรณ์สมาร์ท: สามารถจดจำเสียงของสมาชิกในครอบครัวแต่ละคนเพื่อปรับแต่งการตั้งค่าและค่ากำหนดต่างๆ ให้เหมาะสมกับแต่ละบุคคล อุปกรณ์แฮนด์ฟรีแต่ละตัวจะทำงานโดยใช้คำสั่งปลุก และการสร้างคำสั่งปลุกที่แม่นยำและเฉพาะเจาะจงสำหรับผลิตภัณฑ์ของคุณนั้นต้องอาศัยการปรับแต่งเป็นพิเศษ ข้อมูลการฝึกอบรมคำปลุก.
- พิมพ์ดีดเสียง:ใช้เป็นเครื่องมือเพิ่มผลผลิตในการป้อนข้อมูลและการทำงานอัตโนมัติ ช่วยเพิ่มประสิทธิภาพและความแม่นยำในสภาพแวดล้อมต่างๆ
- บริการลูกค้า:
- ศูนย์บริการ: ระบุลูกค้าด้วยเสียง ทำให้สามารถให้บริการส่วนบุคคลได้ และลดความจำเป็นในการยืนยันตัวตนซ้ำๆ
- การธนาคาร: ตรวจสอบลูกค้าระหว่างการทำธุรกรรมทางโทรศัพท์เพื่อการบริการที่ปลอดภัยและมีประสิทธิภาพ
- ซอฟต์แวร์แปลงคำพูดเป็นข้อความ:แปลงภาษาพูดเป็นข้อความเขียน ช่วยเพิ่มประสิทธิภาพ การบริการลูกค้า และความแม่นยำในการสื่อสาร
- การดูแลสุขภาพ:
- การรับรองความถูกต้องของผู้ป่วย: ยืนยันตัวตนของผู้ป่วยในบริการสุขภาพทางไกลและบันทึกสุขภาพอิเล็กทรอนิกส์
- เสียงไบโอเมตริกซ์สำหรับการตรวจสอบ: ติดตามผู้ป่วยที่มีอาการเช่นภาวะซึมเศร้าโดยการวิเคราะห์การเปลี่ยนแปลงรูปแบบเสียง
- ผู้ช่วยเสมือนของแพทย์: แปลงคำพูดของแพทย์เป็นข้อความเพื่อให้แพทย์สามารถดูและวิเคราะห์ผู้ป่วยได้มากขึ้นในระหว่างวัน
- แอปพลิเคชันบุคคลที่สาม:ผู้ช่วยทางการแพทย์และเครื่องมือดูแลสุขภาพบูรณาการการจดจำเสียงเพื่อเพิ่มประสิทธิภาพการใช้งาน
- ยานยนต์:
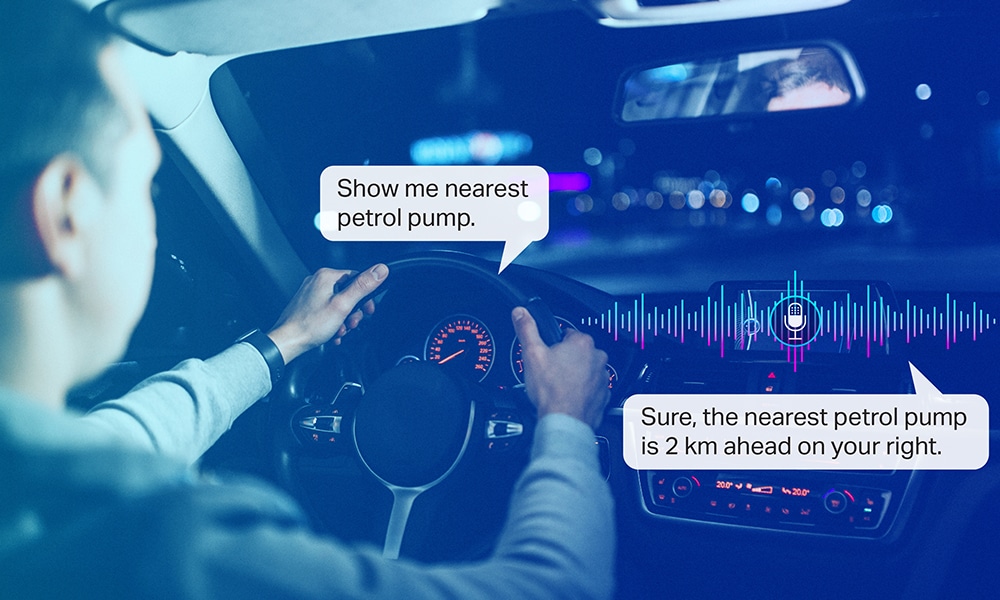
- ระบบในรถยนต์: จดจำเสียงคนขับเพื่อปรับการตั้งค่า เข้าถึงการนำทาง และควบคุมระบบสาระบันเทิงโดยไม่ต้องป้อนข้อมูลด้วยตนเอง
- ประสบการณ์แฮนด์ฟรี: รับสายโทรศัพท์ เปลี่ยนเพลง ตอบข้อความ หรือขอเส้นทางโดยไม่ต้องลุกจากพวงมาลัย ซึ่งไม่เพียงเพิ่มความปลอดภัยบนท้องถนน แต่ยังมอบประสบการณ์การขับขี่ที่ดียิ่งขึ้นอีกด้วย
- กฎหมายและนิติเวช:
- การระบุด้วยเสียง: ใช้ในการสืบสวนทางกฎหมายเพื่อระบุผู้พูดในการบันทึกเสียง
- การเฝ้าระวังความปลอดภัย: ยกระดับมาตรการรักษาความปลอดภัยโดยการระบุตัวบุคคลผ่านเสียงในระบบเฝ้าระวัง
- การรายงานศาล:การจดจำเสียงขั้นสูงใช้สำหรับถอดความทางกฎหมายที่แม่นยำในระหว่างการพิจารณาคดีและการให้การในศาล ช่วยเพิ่มประสิทธิภาพและความแม่นยำเมื่อเทียบกับวิธีการรายงานคดีในศาลแบบดั้งเดิม
- ความบันเทิง:
- การเล่นเกม: ปรับแต่งประสบการณ์การเล่นเกมในแบบของคุณด้วยการจดจำเสียงของผู้เล่น
- อุปกรณ์สื่อ: ระบุผู้ใช้เพื่อปรับแต่งการแนะนำเนื้อหาและโปรไฟล์บนอุปกรณ์สตรีมมิ่ง
- โทรคมนาคม:
- การสื่อสารที่ปลอดภัย: รับประกันช่องทางการสื่อสารที่ปลอดภัยโดยการตรวจสอบตัวตนของผู้เข้าร่วมในการโทรที่เป็นความลับ
- อินเทอร์เฟซเสียง:เปิดใช้งานการโต้ตอบแบบสนทนาที่เป็นธรรมชาติใน AI เชิงสร้างสรรค์และอุปกรณ์อัจฉริยะ ช่วยให้ประสบการณ์ของผู้ใช้มีความเป็นธรรมชาติมากขึ้น
- อุปกรณ์หลายชนิดและอุปกรณ์พกพา:เทคโนโลยีการจดจำเสียงทำงานได้อย่างราบรื่นบนอุปกรณ์ต่างๆ รวมถึงอุปกรณ์พกพาและโทรศัพท์ Android รองรับประสิทธิภาพการทำงานและประสบการณ์ของผู้ใช้ขณะเดินทาง
- การทำงานของซอฟต์แวร์การจดจำ:ซอฟต์แวร์การจดจำสมัยใหม่ทำงานโดยรองรับภาษาต่างๆ รองรับหลายภาษา และให้ความเข้ากันได้กับอุปกรณ์เคลื่อนที่และแพลตฟอร์มต่างๆ สำหรับการควบคุมด้วยเสียง
- งานซอฟต์แวร์การจดจำเสียง:ซอฟต์แวร์การจดจำเสียงทำงานได้บนแพลตฟอร์มที่แตกต่างกัน รองรับหลายภาษา และรวมเข้ากับแอปพลิเคชันของบริษัทอื่นเพื่อการใช้งานที่มีประสิทธิภาพมากขึ้น
- รองรับภาษาต่างๆ:ระบบการจดจำเสียงสมัยใหม่สามารถสลับระหว่างภาษา สำเนียง และสำเนียงต่างๆ ได้ ทำให้มีความยืดหยุ่นในการใช้งานทั่วโลก
ตัวอย่างเทคโนโลยีการจดจำเสียง
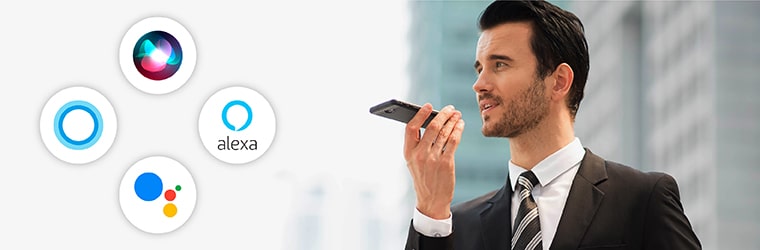
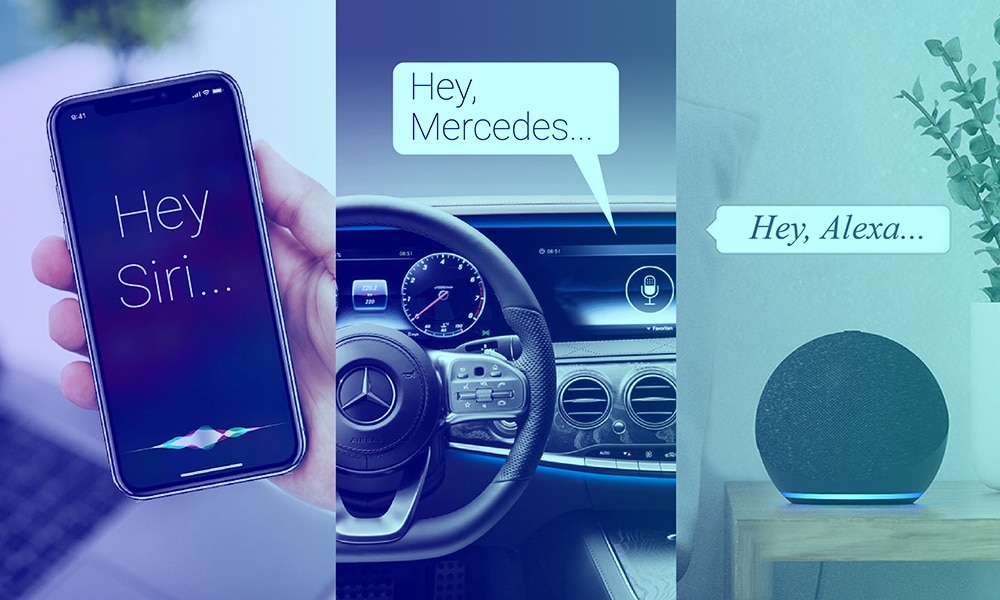
- แอปเปิ้ลสิริ: ลองนึกภาพการมีเพื่อนที่ฉลาดและรอบรู้อยู่ในกระเป๋าของคุณ ซึ่งพร้อมที่จะช่วยเหลือเสมอ นั่นคือ Siri สำหรับคุณ ไม่ว่าคุณจะรีบไปประชุมและต้องการส่งข้อความด่วน หรือกำลังยุ่งอยู่กับคุกกี้และต้องตั้งเวลา Siri ก็อยู่ที่นั่น จดจำเสียงของคุณและตอบสนองด้วยสัมผัสแห่งบุคลิกภาพ เหมือนมีผู้ช่วยส่วนตัวที่รู้จักคุณดีจนแทบจะพูดจบประโยคได้เลย
- อเมซอน อเล็กซ่า: ลองนึกภาพเดินเข้าไปในบ้านของคุณหลังจากเหน็ดเหนื่อยมาทั้งวันแล้วพูดว่า “Alexa ฉันถึงบ้านแล้ว” ทันใดนั้น เพลย์ลิสต์เพื่อการผ่อนคลายที่คุณชื่นชอบก็เริ่มเล่น แสงไฟสลัวตามยามเย็นที่คุณต้องการ และ Alexa จะเตือนคุณเกี่ยวกับรายการที่คุณตั้งใจจะดู เหมือนกับบ้านของคุณที่ให้อ้อมกอดที่แสนสบายและเป็นส่วนตัวทุกครั้งที่คุณกลับมา
- ผู้ช่วยของ Google: คิดว่า Google Assistant เป็นเพื่อนที่รอบรู้ของคุณ ไม่ว่าคุณจะสงสัยเกี่ยวกับสภาพอากาศ ต้องการยุติการอภิปรายที่เป็นมิตร หรือต้องการควบคุมบ้านอัจฉริยะของคุณ ทุกอย่างก็อยู่ที่นั่น จดจำเสียงของคุณและปรับแต่งการตอบสนองให้เหมาะกับคุณโดยเฉพาะ มันเหมือนกับมีเพื่อนที่ฉลาดสุดๆ ที่กระตือรือร้นที่จะช่วยเหลืออยู่เสมอและไม่เคยเบื่อกับคำถามของคุณ
- Nuance Dragon พูดอย่างเป็นธรรมชาติ: ลองนึกภาพการที่คุณสามารถระบายความคิดของคุณลงบนกระดาษได้เร็วที่สุดเท่าที่คุณจะพูดได้ นั่นคือความมหัศจรรย์ของ Dragon NaturallySpeaking สำหรับนักเขียนนวนิยายที่กำลังเขียนหนังสือขายดีเล่มต่อไป หรือแพทย์ที่อัพเดทบันทึกผู้ป่วย ก็เหมือนกับการมีผู้ถอดเสียงที่มีประสิทธิภาพสูงสุดและไม่เคยเหนื่อยที่เข้าใจทุกถ้อยคำ สำเนียง และความแตกต่างเล็กๆ น้อยๆ ในน้ำเสียงของคุณ ไม่ใช่แค่การพิมพ์เท่านั้น แต่ยังปลดปล่อยความคิดของคุณอีกด้วย
- ไมโครซอฟต์ คอร์ทาน่า: Cortana เปรียบเสมือนการมีผู้จัดงานส่วนตัวที่นำหน้าอยู่เสมอ ลองนึกภาพตัวเองในเช้าวันจันทร์ที่วุ่นวาย แล้ว Cortana ก็พูดว่า: “จากเสียงของคุณ คุณดูเครียดเล็กน้อย ฉันขอจัดตารางการประชุมที่เร่งด่วนน้อยกว่าของคุณไว้ช่วงปลายสัปดาห์นี้ได้ไหม” ไม่ใช่แค่การจัดการตารางเวลาของคุณเท่านั้น มันเกี่ยวกับการมีพันธมิตรทางดิจิทัลที่เข้าใจถึงความแตกต่างเล็กๆ น้อยๆ ในน้ำเสียงของคุณ และช่วยให้วันของคุณราบรื่นยิ่งขึ้น