
2
คำอธิบายวลีสำคัญ (KP)
ระบุคำนามที่ไม่ต่อเนื่องในข้อความ คำนามอาจเป็นคำธรรมดาก็ได้ (เช่น คำนำหน้าเดียว เช่น คำนาม คำสรรพนาม หรือคำสรรพนาม) หรือซับซ้อน (เช่น คำนามที่มีคำนำหน้าพร้อมกับตัวดัดแปลงที่เกี่ยวข้อง)

การระบุข้อมูลเอนทิตีที่แม่นยำโดยมีมนุษย์เข้ามาเกี่ยวข้องสำหรับการฝึกอบรม NLP, LLM และ RAG — ปลอดภัย ปรับขนาดได้ และให้บริการในกว่า 60 ภาษา
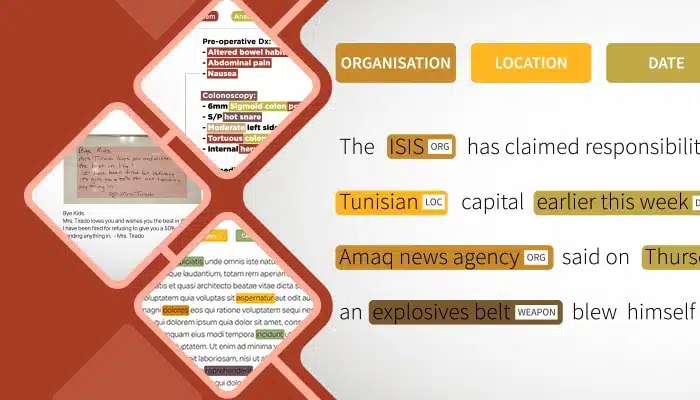
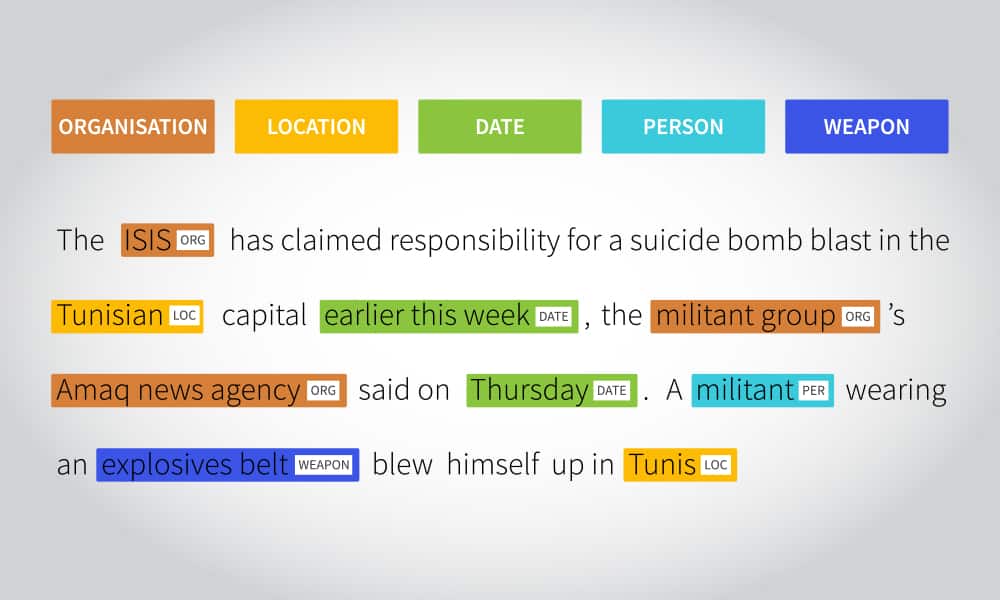
Named Entity Recognition (NER) ระบุและจัดประเภทเอนทิตี เช่น บุคคล องค์กร และสถานที่ภายในข้อความที่ไม่มีโครงสร้าง NER ปรับปรุงการสกัดข้อมูล ลดความซับซ้อนในการดึงข้อมูล และขับเคลื่อนแอปพลิเคชัน AI ขั้นสูง ทำให้เป็นเครื่องมือสำคัญสำหรับธุรกิจในการใช้ประโยชน์ ด้วย NER องค์กรต่างๆ สามารถรับข้อมูลเชิงลึกอันมีค่า ปรับปรุงประสบการณ์ของลูกค้า และเพิ่มความคล่องตัวให้กับกระบวนการต่างๆ
Shaip NER ออกแบบมาเพื่อให้องค์กรต่างๆ สามารถปลดล็อกข้อมูลสำคัญในข้อมูลที่ไม่มีโครงสร้าง และช่วยให้คุณค้นพบความสัมพันธ์ระหว่างหน่วยงานต่างๆ จากงบการเงิน เอกสารประกัน บทวิจารณ์ บันทึกของแพทย์ เป็นต้น นอกจากนี้ NER ยังช่วยระบุความสัมพันธ์ระหว่างหน่วยงานประเภทเดียวกันได้ เช่น องค์กรหลายแห่งหรือบุคคลที่กล่าวถึงในเอกสาร ซึ่งมีความสำคัญต่อความสม่ำเสมอในการแท็กหน่วยงานและการปรับปรุงความถูกต้องของโมเดล ด้วยประสบการณ์อันยาวนานใน NLP และภาษาศาสตร์ เราจึงพร้อมที่จะมอบข้อมูลเชิงลึกเฉพาะโดเมนเพื่อจัดการโครงการคำอธิบายประกอบในทุกขนาด
เหตุใดทีมต่างๆ จึงจ้าง Shaip มาทำการวิเคราะห์ NER จากภายนอก
การเปลี่ยนข้อความดิบที่ไม่เป็นระเบียบให้เป็นข้อมูล NER ที่พร้อมสำหรับการฝึกอบรมนั้นเป็นเรื่องยากหากคุณไม่มีทีมงานด้านการระบุคำ (annotation team) เป็นของตัวเอง เราจัดการกระบวนการนี้ตั้งแต่ต้นจนจบอย่างแม่นยำ ปลอดภัย และในขนาดที่โมเดลของคุณต้องการ
สิ่งที่เราทำ
บริการครบวงจรด้านการระบุชื่อเอนทิตี (Named Entity Recognition: NENTI) ตั้งแต่เอนทิตีทั่วไปจนถึงโดเมนเฉพาะทางที่มีข้อกำหนดเข้มงวดที่สุด
การจดจำเอนทิตีที่มีชื่อใน Machine Learning เป็นส่วนหนึ่งของการประมวลผลภาษาธรรมชาติ วัตถุประสงค์หลักของ NER คือการประมวลผลข้อมูลที่มีโครงสร้างและไม่มีโครงสร้าง และจัดประเภทเอนทิตีที่มีชื่อเหล่านี้เป็นหมวดหมู่ที่กำหนดไว้ล่วงหน้า หมวดหมู่ทั่วไปบางหมวดหมู่ได้แก่ ชื่อ เอนทิตีบุคคล ที่ตั้ง บริษัท เวลา มูลค่าทางการเงิน เหตุการณ์ และอื่นๆ

การระบุบุคคล สถานที่ องค์กร วันที่ และเอนทิตีทั่วไปอื่นๆ ในข้อความทั่วไป เช่น ข่าวสาร เนื้อหาบนเว็บไซต์ อีเมล และบทสนทนากับลูกค้า โดยมีการติดป้ายกำกับอย่างสม่ำเสมอเพื่อฝึกฝนโมเดล NER ให้เข้าใจภาษาในวงกว้าง

การดึงข้อมูลสำคัญจากเอกสารประกันภัย รวมถึงจำนวนเงินเอาประกันภัย วงเงินชดเชย และวงเงินความคุ้มครองตามกรมธรรม์ ข้อมูลประมาณการต่างๆ เช่น ค่าจ้างพนักงาน ยอดขาย และรายได้ค่าธรรมเนียม รายการยานพาหนะ และส่วนขยายกรมธรรม์พร้อมวงเงินภายใน

การระบุปัญหา โครงสร้างทางกายวิภาค ยา และขั้นตอนการรักษาในบันทึกทางการแพทย์ที่ไม่เป็นระเบียบ เช่น บันทึกสุขภาพอิเล็กทรอนิกส์ (EHR) และบันทึกของแพทย์ โดยมีผู้เชี่ยวชาญด้านการดูแลสุขภาพเป็นผู้เพิ่มเติมข้อมูล เพื่อเปลี่ยนข้อความทางคลินิกที่ซับซ้อนให้เป็นข้อมูลที่มีโครงสร้างและใช้งานได้
ระบุคำนามที่ไม่ต่อเนื่องในข้อความ คำนามอาจเป็นคำธรรมดาก็ได้ (เช่น คำนำหน้าเดียว เช่น คำนาม คำสรรพนาม หรือคำสรรพนาม) หรือซับซ้อน (เช่น คำนามที่มีคำนำหน้าพร้อมกับตัวดัดแปลงที่เกี่ยวข้อง)

PII หมายถึงข้อมูลส่วนบุคคลที่สามารถระบุตัวตนได้ งานนี้เกี่ยวข้องกับการใส่คำอธิบายประกอบของตัวระบุหลักใดๆ ที่สามารถเชื่อมโยงกับตัวตนของบุคคลได้

PHI หมายถึงข้อมูลสุขภาพที่ได้รับการคุ้มครอง งานนี้เกี่ยวข้องกับการใส่คำอธิบายประกอบของตัวระบุผู้ป่วยที่สำคัญ 18 ตัวตามที่ระบุภายใต้ HIPAA เพื่อที่จะยกเลิกการระบุบันทึก/ตัวตนของผู้ป่วย
การระบุข้อมูล เช่น ใคร อะไร เมื่อใด ที่ไหนเกี่ยวกับเหตุการณ์ เช่น การโจมตี การลักพาตัว การลงทุน เป็นต้น กระบวนการคำอธิบายประกอบนี้มีขั้นตอนดังต่อไปนี้:
การระบุตัวตนของหน่วยงาน (เช่น บุคคล สถานที่ องค์กร เป็นต้น)

การระบุคำที่บ่งบอกถึงเหตุการณ์หลัก (เช่น คำกระตุ้น)

การระบุความสัมพันธ์ระหว่างทริกเกอร์และประเภทของเอนทิตี
ความลึกซึ้งและความซับซ้อน
ไม่ว่าโครงสร้างข้อมูลเอนทิตีของคุณจะต้องการอะไร เครื่องมือช่วยอธิบายของเราก็จัดการได้หมด รวมถึงกรณีที่ยากลำบากซึ่งผู้ให้บริการส่วนใหญ่หลีกเลี่ยง
ประเภทเอนทิตีหลักที่ติดป้ายกำกับตามสคีมาของคุณ
ประเภทเอนทิตีที่ออกแบบมาโดยเฉพาะสำหรับอุตสาหกรรมและกรณีการใช้งานของคุณ
เป็นการแบ่งย่อยเป็นประเภทและลำดับชั้น ไม่ใช่แค่การจัดกลุ่มแบบกว้างๆ
การจัดการเอนทิตีซ้อนเอนทิตีอย่างแม่นยำ
ป้ายกำกับที่ถูกต้องหลายรายการต่อช่วง (span) ในกรณีที่บริบทกำหนด
เพิ่มคุณลักษณะและความสัมพันธ์ให้กับเอนทิตีต่างๆ
แปลงรูปแบบต่างๆ ให้เป็นเอนทิตีมาตรฐานเดียว
ข้อมูลมาตรฐานที่ผ่านการพิจารณาและพร้อมสำหรับการตรวจสอบแล้ว
สร้างขึ้นเพื่อ AI ยุคใหม่
ข้อมูลที่มีการติดป้ายกำกับเอนทิตีนั้นมีประโยชน์มากกว่าแค่การขับเคลื่อนกระบวนการประมวลผลภาษาธรรมชาติแบบดั้งเดิม มันช่วยวางรากฐานการค้นหาข้อมูล สร้างโครงสร้างความรู้สำหรับ RAG และปรับปรุงโมเดลที่ปรับแต่งมาอย่างละเอียดให้คมชัดยิ่งขึ้นสำหรับเอนทิตีที่มีความสำคัญต่อธุรกิจของคุณ
เราสร้างชุดข้อมูลที่ช่วยให้โมเดลของคุณสามารถดึงข้อมูลเอนทิตีที่ถูกต้องได้อย่างน่าเชื่อถือ ในโดเมนของคุณ และในระดับการใช้งานจริง
อุตสาหกรรมที่เราให้บริการ
ดึงข้อมูลโรค ยา และขั้นตอนการรักษาจากบันทึกทางการแพทย์และการวิจัย เพื่อใช้เป็นพลังขับเคลื่อน AI ทางการแพทย์
ดึงข้อมูลบริษัท จำนวนเงิน และตราสารจากเอกสารการยื่นและงบการเงินเพื่อประเมินความเสี่ยงและการปฏิบัติตามกฎระเบียบ
ระบุคู่สัญญา ข้อกำหนด และภาระผูกพันในสัญญาและเอกสารคดีต่างๆ
จัดเส้นทางและจำแนกประเภทตั๋วโดยแยกผลิตภัณฑ์ ปัญหา และจุดประสงค์จากข้อความ
ติดแท็กแบรนด์ ผลิตภัณฑ์ และคุณลักษณะต่างๆ เพื่อปรับปรุงการค้นหา คำแนะนำ และแคตตาล็อก
ติดตามบุคคล องค์กร และสถานที่เพื่อการตรวจสอบ การวิจัย และการบันทึกขั้นตอนการทำงาน
ขนาด ความเชี่ยวชาญ และความแม่นยำที่คุณวางใจได้
สร้าง ดูแล และรวบรวมชุดข้อมูลที่สร้างขึ้นเอง (ข้อความ คำพูด รูปภาพ วิดีโอ) จากทั่วโลกโดยอิงตามแนวทางที่กำหนดเอง
ใช้ประโยชน์จากบุคลากรภายในองค์กรกว่า 10,000 คนทั่วโลก และผู้ร่วมงานที่มีคุณสมบัติครบถ้วนกว่า 500 คนจากภายนอกองค์กร เพิ่มประสิทธิภาพและศักยภาพของกำลังคนแบบเรียลไทม์
แพลตฟอร์มที่เป็นกรรมสิทธิ์ของเราและพนักงานที่มีทักษะใช้หลายวิธีการควบคุมคุณภาพเพื่อตอบสนองหรือเกินมาตรฐานคุณภาพ
กระบวนการของเราช่วยปรับปรุงกระบวนการรวบรวมข้อมูลให้มีประสิทธิภาพยิ่งขึ้น ด้วยการกระจายงานที่ง่ายขึ้น และการบันทึกข้อมูลโดยตรงจากแอปพลิเคชันและเว็บไซต์
รักษาความลับของข้อมูลทั้งหมดโดยให้ความสำคัญกับความเป็นส่วนตัวของเรา เรารับรองว่ารูปแบบข้อมูลจะถูกควบคุมและรักษาไว้ตามนโยบาย
ชุดข้อมูลที่รวบรวมได้ทั้งหมดสามารถใส่คำอธิบายประกอบ ติดป้ายกำกับ ถอดความ และตรวจสอบความถูกต้องได้ในขั้นตอนการทำงานเดียวกัน ทำให้ได้ข้อมูลฝึกฝนที่พร้อมใช้งานสำหรับโมเดล
วิธีการทำงาน
กระบวนการทำงานที่ชัดเจนและเป็นระบบ ตั้งแต่รับบรีฟจนถึงส่งมอบงาน โดยเน้นคุณภาพในทุกขั้นตอน
เราจะกำหนดโครงสร้างข้อมูลเอนทิตี กรณีพิเศษ และข้อกำหนดของโดเมนให้ตรงกัน จากนั้นจึงกำหนดแนวทางการเขียนคำอธิบายประกอบ
ผู้ให้ข้อมูลที่ผ่านการฝึกอบรมเฉพาะด้านจะติดป้ายกำกับข้อมูลของคุณ โดยมีหัวหน้าทีมคอยให้คำแนะนำเพื่อให้การตัดสินใจมีความสอดคล้องกัน
กระบวนการตรวจสอบหลายขั้นตอน การตัดสิน และการตรวจสอบความสอดคล้องระหว่างผู้ประเมินก่อนส่งมอบเพื่อการฝึกอบรม
Shaip เปลี่ยนข้อมูลที่ซับซ้อนและละเอียดอ่อนให้เป็นชุดข้อมูลพร้อมสำหรับการฝึกอบรมได้อย่างปลอดภัยและในปริมาณมากได้อย่างไร

ปัญหา:การค้นหาข้อมูลนับล้านครั้งต่อวัน เต็มไปด้วยคำผิด ความคลุมเครือ และหมวดหมู่ที่ซ้ำซ้อน ส่งผลเสียต่อความเกี่ยวข้องของผลการค้นหาและประสบการณ์ของลูกค้า
วิธีแก้ปัญหา:กรอบการทำงานสำหรับการระบุประเภทข้อมูล 11 ประเภท พร้อมกฎลำดับความสำคัญที่ชัดเจน และขั้นตอนการทำงาน 3 ขั้นตอน ได้แก่ การระบุประเภทข้อมูล การตรวจสอบคุณภาพ และการตัดสินโดยผู้เชี่ยวชาญเฉพาะด้านสำหรับกรณีพิเศษ
ผลลัพธ์:จัดประเภทคำค้นหามากกว่า 50,000 รายการด้วยความแม่นยำสูง ช่วยเพิ่มความเกี่ยวข้อง การค้นหาผลิตภัณฑ์ และความพึงพอใจของผู้ใช้

ปัญหา:ผู้นำด้านการดูแลสุขภาพต้องการวิเคราะห์ข้อมูลเวชระเบียนผู้ป่วยมะเร็งจำนวนมากเพื่อใช้เทคโนโลยีการประมวลผลภาษาธรรมชาติ (NLP) โดยไม่กระทบต่อความเป็นส่วนตัวของผู้ป่วยหรือความถูกต้องแม่นยำทางการแพทย์
วิธีแก้ปัญหา:ข้อมูลที่คัดสรรจากเวชระเบียนมากกว่า 5 ล้านรายการ การปกปิดข้อมูลส่วนบุคคลตามหลักเกณฑ์ HIPAA Safe Harbor และผู้เชี่ยวชาญด้านมะเร็งวิทยาที่ทำการระบุข้อมูลเกี่ยวกับโรค ความสัมพันธ์ และการปฏิเสธในกลุ่มผู้ป่วย
ผลลัพธ์:ข้อมูลคุณภาพสูงกว่า 10,000 รายการ ที่ถูกปกปิดข้อมูลส่วนบุคคลและติดป้ายกำกับไว้แล้ว — ชุดข้อมูลที่ปลอดภัยและพร้อมสำหรับการฝึกฝนเพื่อพัฒนาโมเดล NLP ของลูกค้า


ติดต่อเราตอนนี้เพื่อเรียนรู้วิธีที่เราสามารถรวบรวมชุดข้อมูล NER ที่กำหนดเองสำหรับโซลูชัน AI/ML เฉพาะของคุณ
บริการการติดป้ายกำกับ NER ให้ข้อมูลการฝึกอบรมที่ติดป้ายกำกับโดยผู้เชี่ยวชาญสำหรับการระบุเอนทิตีที่มีชื่อ — ทีมงานจะติดป้ายกำกับเอนทิตี เช่น บุคคล องค์กร สถานที่ วันที่ และคำศัพท์เฉพาะด้านในข้อความของคุณ เพื่อให้โมเดล NLP หรือ LLM ของคุณสามารถเรียนรู้ที่จะแยกเอนทิตีเหล่านั้นได้อย่างแม่นยำ Shaip ให้บริการแบบครบวงจร รวมถึงแนวทาง การติดป้ายกำกับ และการควบคุมคุณภาพหลายรอบ
ผู้ให้บริการข้อมูล AI เฉพาะทางอย่าง Shaip สร้างชุดข้อมูล NER แบบกำหนดเอง Shaip นำเสนอข้อมูลเอนทิตีเฉพาะด้านหลายภาษา รวมถึงข้อมูลทางคลินิก การเงิน และ PII/PHI พร้อมระบบรักษาความปลอดภัยระดับองค์กรและการตรวจสอบคุณภาพโดยมนุษย์ พร้อมใช้งานสำหรับการประมวลผลภาษาธรรมชาติ (NLP) การจัดการภาษา (LLM) การจัดกลุ่มตามเหตุผล (RAG) และการปรับแต่งอย่างละเอียด
ค่าใช้จ่ายขึ้นอยู่กับปริมาณข้อมูล จำนวนและความซับซ้อนของประเภทข้อมูล ภาษา ความเชี่ยวชาญเฉพาะด้านที่จำเป็น และเป้าหมายด้านคุณภาพและระยะเวลาในการส่งมอบงาน Shaip จะประเมินขอบเขตของแต่ละโครงการให้ตรงกับความต้องการของคุณ และสามารถเริ่มต้นด้วยโครงการนำร่องฟรี เพื่อให้คุณได้เห็นคุณภาพและราคา ก่อนที่จะตัดสินใจใช้บริการอย่างถาวร
ใช่แล้ว Shaip ระบุข้อมูลสำคัญอย่างสม่ำเสมอในกว่า 60 ภาษาและอักษร โดยใช้ผู้ระบุข้อมูลที่เป็นเจ้าของภาษาและระบบตรวจสอบคุณภาพเฉพาะภาษา
ใช่แล้ว Shaip ให้บริการระบุชื่อเอนทิตีทางคลินิกและทางการแพทย์ (NER) และการระบุข้อมูลส่วนบุคคลที่ระบุตัวตนได้ (PII/PHI) ครอบคลุมตัวระบุ HIPAA ทั้ง 18 รายการ โดยดำเนินการโดยผู้เชี่ยวชาญที่ได้รับการฝึกอบรมเฉพาะด้าน ภายใต้เวิร์กโฟลว์ที่ปลอดภัยและสอดคล้องกับ HIPAA
แนวทางการให้คำอธิบายที่ชัดเจน ผู้ให้คำอธิบายที่ได้รับการฝึกอบรมในสาขาที่เกี่ยวข้อง การกำกับดูแลโดยหัวหน้าทีม และการตรวจสอบคุณภาพหลายขั้นตอน พร้อมการตัดสินและการตรวจสอบความสอดคล้องระหว่างผู้ให้คำอธิบายก่อนส่งมอบงาน
การรักษาความปลอดภัยเป็นสิ่งสำคัญอันดับแรก: มีข้อตกลงรักษาความลับ (NDA) โดยอัตโนมัติ การควบคุมการเข้าถึง และกระบวนการที่สอดคล้องกับ HIPAA, SOC 2, ISO 27001, GDPR และ CCPA ข้อมูลของคุณจะได้รับการปกป้องตลอดระยะเวลาการทำงานร่วมกัน
โครงการส่วนใหญ่สามารถเริ่มต้นได้ภายในไม่กี่วัน เวอร์ชั่นทดลองใช้งานฟรีช่วยให้คุณตรวจสอบคุณภาพได้อย่างรวดเร็ว หลังจากนั้น Shaip จะขยายขนาดให้รองรับปริมาณงานเต็มรูปแบบของคุณตามกรอบเวลาที่ตกลงกันไว้

เราใช้คุกกี้เพื่อปรับปรุงประสบการณ์ของคุณบนไซต์ของเรา โดยการใช้ไซต์ของเรา คุณยินยอมให้ใช้คุกกี้
จัดการการตั้งค่าคุกกี้ของคุณด้านล่าง:
คุกกี้ที่จำเป็นต้องใช้งานฟังก์ชั่นพื้นฐานและจำเป็นสำหรับการทำงานที่เหมาะสมของเว็บไซต์
Google Tag Manager ช่วยให้การจัดการแท็กการตลาดบนเว็บไซต์ของคุณง่ายขึ้น โดยไม่ต้องแก้ไขโค้ด
คุกกี้สถิติรวบรวมข้อมูลโดยไม่ระบุตัวตน ข้อมูลนี้ช่วยให้เราเข้าใจว่าผู้เยี่ยมชมใช้เว็บไซต์ของเราอย่างไร
Google Analytics เป็นเครื่องมืออันทรงพลังที่ติดตามและวิเคราะห์ปริมาณการเข้าชมเว็บไซต์เพื่อการตัดสินใจทางการตลาดอย่างรอบรู้
URL ของบริการ: policies.google.com (เปิดในหน้าต่างใหม่)
คุกกี้การตลาดใช้เพื่อติดตามผู้เยี่ยมชมเว็บไซต์ จุดประสงค์คือเพื่อแสดงโฆษณาที่เกี่ยวข้องและดึงดูดความสนใจของผู้ใช้แต่ละราย
Google Ads คือแพลตฟอร์มโฆษณาออนไลน์ที่ช่วยให้ธุรกิจต่างๆ สามารถสร้างโฆษณาแบบกำหนดเป้าหมายซึ่งจะแสดงบนผลการค้นหาของ Google และเว็บไซต์พันธมิตรได้
URL ของบริการ: policies.google.com (เปิดในหน้าต่างใหม่)
Hub HubSpot คือแพลตฟอร์มการตลาด การขาย และบริการลูกค้าแบบครบวงจร ที่ช่วยให้ธุรกิจเติบโตได้อย่างราบรื่น
URL บริการ: legal.hubspot.com (เปิดในหน้าต่างใหม่)
คุณสามารถดูข้อมูลเพิ่มเติมได้ในนโยบายคุกกี้และนโยบายความเป็นส่วนตัว ของ เรา